
Bash Scripting : apprentissage par problème dans une perspective de défense en sécurité informatique
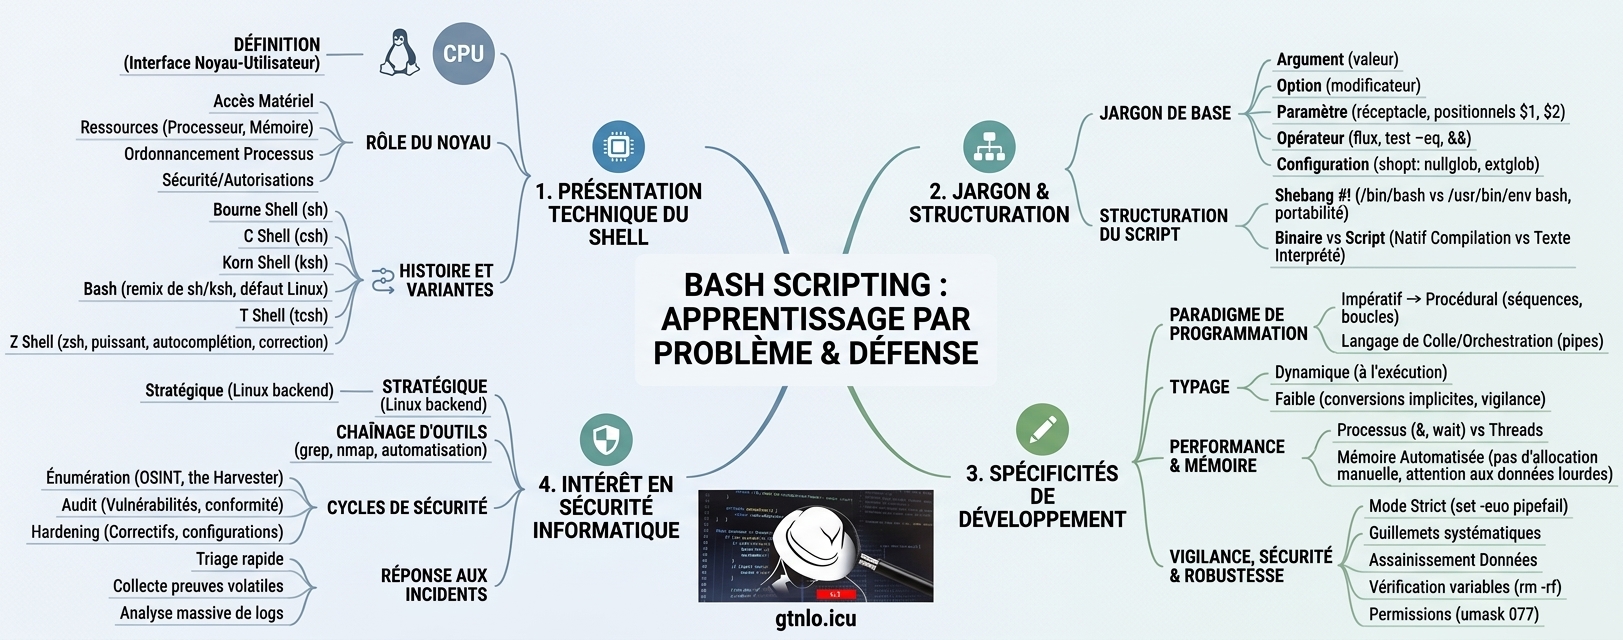
Outil magique, outil de fantasme, il fait rêver les uns, il n’a eu de cesse d’agir tel un aphrodisiaque sur les autres : le shell. S’il est particulièrement mis en exergue dans les grandes scènes cinématographiques, ce n’est pas seulement pour nous plonger dans un univers captivant de puissance numérique au cœur de tout système informatique sérieux. Car oui, le shell est un outil puissant, redoutable et toujours aussi présent tant pour les travaux d’administration, que servant d’arme secrète aux opérations de sécurité. Comment apprendre à utiliser le shell de façon professionnelle dans une perspective de sécurité informatique ? Nous nous focalisons sur le développement de scripts Bash. Avec une pédagogie qui se veut à fort gain de savoir-penser et de savoir-faire. Nous faisons un bref tour d’horizon pour comprendre d’où l’on vient, quelles sont les spécificités du langage employé suivant des concepts universels de programmation et comment aborder des problèmes, pour développer des solutions par l’exemple. Premier jet de tout un programme, le fer de lance d’une ligne de contenu spécialisé de ce blog, repose sur la capacité à pouvoir construire soi-même ses outils de sécurité non pas pour attaquer, ce qui pilule déjà ici et ailleurs, mais pour défendre. Et ce, pensez-y, vous apprenez deux fois plus qu’en étant dans une perspective d’attaque simple usant d’outils génériques sans ingénierie additive personnelle sur le plan technique. Chaque mini-projet nous fera ainsi gagner en acquis et il sera davantage possible d’aller plus loin via des liens et des fiches d’approfondissements portés par des mindmaps et des aide-mémoires faciles à garder et à reconsulter à souhait. Ceci dit, ce post se veut particulièrement dynamique en mises à jour.
1. Présentation technique du shell et de ses variantes
Un shell permet aux utilisateurs d’interagir avec le noyau d’un système d’exploitation en acceptant des commandes et en les exécutant. C’est généralement ce que les scénaristes essaient de projeter lorsqu’on voit des informaticiens tapoter frénétiquement un clavier pour faire exécuter des instructions textuelles. Pour ainsi dire, le shell sert d’interface entre l’utilisateur et le système d’exploitation dont le noyau constitue la partie névralgique.
En effet, c’est le noyau qui est chargé de :
- Contrôler l’accès aux périphériques matériels ;
- Gérer les ressources processeur, mémoire et de stockage ;
- Gérer l’ordonnancement et l’exécution des processus ;
- Appliquer les règles de sécurité et les autorisations d’accès.
Sous Linux qui a fait la popularité de cet outil et qui constitue notre environnement de base, plusieurs shells ont vu leur apparition au fil de l’histoire. Chacun conçu avec des fonctionnalités et des objectifs d’utilisation différents, ils varient en termes de performances, de capacités de script et d’interaction avec l’utilisateur. Toutefois, c’est la famille de shells Bourne qui a pignon sur rue.
Qu’il s’agisse de sh, bash, ksh, zsh ou autre, la syntaxe que vous apprenez pour l’un est presque entièrement transposable aux autres. Mais il est important de retenir leur ordre d’apparition pour mieux comprendre comment ils pourraient être liés les uns aux autres :
- Bourne Shell (sh) ;
- C Shell (csh) ;
- Korn Shell (ksh) ;
- GNU Bourne-Again Shell (bash) ;
- T Shell (tcsh) ;
- Z Shell (zsh).
Le Bourne Shell du nom de son auteur Steve Bourne a été développé dans les laboratoires Bell d’AT&T, une grande entreprise américaine de télécommunications. Il s’agit du shell UNIX original, qui sert de base à de nombreux shells modernes.
Au fil des ans, le GNU Bourne-Again Shell (bash) s’est imposé comme le plus utilisé sur les systèmes Linux. Tel un remix (Again), il revitalise son ancêtre le Bourne shell (sh) en y intégrant des subtilités et fonctionnalités supplémentaires dont celles du Korn shell (ksh) évoqué dans le listing historique ci-dessus. C’est sans aucun doute ce qui a fait de lui le shell par défaut de la plupart des distributions Linux, même si certaines à l’instar de Kali Linux ont décidé de monter deux crans plus hauts en adoptant le Z Shell (zsh).
Créé par Paul Falstad en 1990, alors qu’il était étudiant à l’université de Princeton, zsh est un shell étendu et hautement personnalisable, basé sur les fonctionnalités de bash et ksh. Si de façon intuitive vous vous dites autant passer à zsh question d’être « à la ligne », vous ne devriez pas perdre de vue que tout ce qui se fait sur bash est également pris en charge par zsh.
zsh est largement compatible avec bash mais offre en plus une série de fonctionnalités puissantes pour le quotidien telles que :
- La correction orthographique des commandes,
- L’autocomplétion intelligente par menu déroulant,
- des thèmes graphiques puissants comme Oh My Zsh.
Pour une meilleure expérience, les experts s’accordent à dire qu’il vaudrait mieux passer à zsh une fois la maîtrise de bash effective. Qui plus est, comme nous l’avons évoqué plus haut, bash est encore le shell par défaut dans de nombreuses distributions Linux. Et même celles ayant embarqué zsh permettent de basculer aisément d’un shell à l’autre.
2. Jargon de base et structuration globale :
2.1. Jargon de base
Pour se retrouver facilement, ne pas se perdre dans les minima et ne pas se mêler les pinceaux dans le jargon des scripts shell, les définitions suivantes s’avèrent capitales :
- Argument : chaîne de caractères, chemin de fichier ou toute autre valeur transmise à une commande, un script ou une fonction lors de son exécution. Exemple : Dans cat fichier.txt, le mot fichier.txt est un argument transmis à la commande cat, dont la fonction principale est de lire, afficher et concaténer (fusionner) le contenu d’un fichier texte.
- Option : modificateur (généralement précédé d’un tiret – ou de deux tirets –) qui change le comportement d’une commande. Une option est techniquement un type particulier d’argument. Exemple : Dans ls -l, -l est une option qui transforme fondamentalement la présentation et la richesse des informations restituées par ls, le rôle de la commande ls étant d’afficher le contenu d’un répertoire.
- Paramètre : terme générique qui désigne une variable ou un réceptacle destiné à recevoir une valeur (comme un argument d’entrée ou une variable interne). Dans les scripts bash, les variables spéciales comme $1, $2 sont appelées des paramètres de position. Exemple : $1 est le paramètre qui récupère le premier argument fourni par l’utilisateur.
- Opérateur : Symbole ou mot-clé réservé interprété directement par le shell pour effectuer une action de flux/contrôle (redirection, tubes, enchaînement), de calcul arithmétique, ou d’évaluation logique et de test (-eq, -z, -r, ==, &&, ||). Bien qu’une option (ex: -l ou -h) puisse visuellement ressembler à un opérateur de test (ex: -z ou -r), leur niveau d’exécution diffère totalement dans la mesure où : une option est un argument transmis à un programme externe ou à une commande pour modifier son comportement interne alors qu’un opérateur est un composant syntaxique du shell, exécuté directement par celui-ci pour évaluer des conditions, structurer la logique d’un script ou manipuler le transfert de données entre processus. Nous pouvons ainsi distinguer « les opérateurs de test et de comparaison » et « les opérateurs de flux et de redirection ».
- Paramètre de configuration : réglage interne qui modifie le comportement global ou structurel d’un outil, d’un shell ou d’un service (contrairement à l’option d’une commande ponctuelle). Dans Bash, on manipule des paramètres de configuration via des commandes comme shopt ou son équivalent setopt dans Zsh, à l’image de nullglob, qui efface complètement un motif de recherche (globbing) s’il ne correspond à aucun fichier au lieu de le laisser intact ou d’émettre une erreur, et de extglob, qui débloque des opérateurs de filtrage avancés inspirés des expressions régulières pour tester des répétitions, des alternatives ou des exclusions directement dans la ligne de commande (comme !(fichier.txt)).
Si vous êtes arrivés jusqu’ici, un grand bravo à vous ! La consolidation de ces notions se fera à coup sûr au fur et à mesure que nous évoluerons dans nos mini-projets défense. Bien évidemment, ils seront enrichis par d’autres intimement liés à la structuration globale d’un script bash.
2.2. Structuration globale
2.2.1. A propos du shebang #!
Le shebang (#!), composé d’un dièse et d’un point d’exclamation placés impérativement sur la première ligne d’un fichier, est une norme fondamentale des systèmes Unix/Linux qui indique au noyau quel interpréteur utiliser pour exécuter un script.
Puisque nous parlons de bash, les scripts de ce type devront obligatoirement commencer par le shebang suivi du chemin pointant vers l’exécutable de cet utilitaire, en l’occurrence # !/bin/bash. Nous pourrons aussi noter certaines variantes du type #!/usr/bin/env bash.
La différence entre ces deux notations réside dans la portabilité. Alors que #!/bin/bash indique au système de rechercher le shell bash via un chemin absolu soit /bin/bash, la notation # !/usr/bin/env bash fait tout d’abord appel à l’utilitaire env qui ira chercher dynamiquement le premier binaire nommé bash disponible dans la variable d’environnement $path de l’utilisateur. Ce faisant, le script pourra s’exécuter sans modification sur n’importe quel système de type Unix, peu importe où bash est installé.
2.2.2. Différence entre exécutable natif ou fichier binaire et script
Il est important de faire la distinction entre exécutable natif ou fichier binaire et script pour bien s’ancrer dans le monde du scripting.
La distinction fondamentale entre ces deux notions réside dans leur mode d’exécution par le système d’exploitation : le fichier binaire est un exécutable natif (issu de la compilation de langages comme C, Go ou Rust) composé de code machine directement compris et chargé en mémoire par le processeur sans intermédiaire, tandis que le script est un simple fichier texte lisible par l’humain qui nécessite impérativement un programme tiers appelé interpréteur à l’instar de Bash, mais aussi Python pour ce qui est du langage de programmation éponyme, Node.js pour le javascript côté serveur et bien d’autres.
Pour traduire et exécuter son code à la volée, le shebang (#!) sus-évoqué sert alors de passerelle permettant au noyau de masquer cette différence à l’utilisateur : lorsqu’un script est lancé directement, le système lit cette première ligne pour identifier et démarrer automatiquement l’interpréteur adéquat auquel il transmet le fichier en argument, qui sera ensuite traduit en langage machine. Ce processus se traduit aussi souvent par compilation à la volée à contrario d’une compilation préalablement effectuée avant exécution, dans le cas de ces langages et environnements de développement permettant de produire directement des exécutables natifs ou des fichiers binaires.
Pour rapidement cerner quel intérêt représenterait l’une ou l’autre approche, nous pourrons tout d’abord relever des contraintes techniques et sécuritaires. Car en effet, le mécanisme de fonctionnement du shell sous Linux est un cas patent : impossible de s’adresser directement au noyau sans passer par le shell. Même les autres programmes font appel à lui lorsqu’il s’agit d’utiliser les ressources systèmes placées sous son contrôle. Sinon de manière générale, on pourra choisir l’une ou l’autre approche selon que l’on recherche de :
- La vitesse à l’exécution : Le code natif ou binaire est plus rapide à l’exécution et là nous ne parlons pas du shell code qui se veut un peu particulier au regard des contraintes techniques et sécuritaires énoncées plus haut. Mais pour les autres langages interprétés, l’interpréteur additionnel qui vient s’intercaler entre le système et le processeur consomme des ressources avant que le code en lui-même ne soit exécuté, ce qui n’est pas le cas des fichiers binaires qui le sont directement.
- La portabilité : L’usage d’interpréteurs permet une meilleure portabilité du code sur n’importe quel système d’exploitation. Le cas du shell, un script écrit sous Ubuntu peut bien fonctionner sur Linux Mint, Debian, ou même Kali Linux, car le shell bash est présent partout et sait lire et interpréter le code fourni.
- Un potentiel de prototypage rapides et /ou des bibliothèques étendues : certains langages et environnements de programmation font choux gras en la matière par leur prise en main qui se veut plus rapide, ainsi que la richesse de l’écosystème qui les entoure ouvrant des possibilités à presque tout, du web à la recherche scientifique en passant par l’IA.
3. Spécificités de développement
3.1. Place du scripting bash dans les différents paradigmes de programmation
Plutôt qu’un simple ensemble de règles syntaxiques propre à un langage (comme la nécessité d’un point-virgule ou la déclaration d’une variable), un paradigme définit la façon de penser l’exécution des instructions et l’état des données.
Pour le définir autrement, nous dirons qu’un paradigme de programmation est un style ou une approche philosophique qui régit la manière dont on conçoit, structure et organise un code informatique ainsi que la résolution de problèmes informatiques.
Au fur et à mesure que les langages de programmation évoluent, de nouveaux styles ou philosophies émergent. Ainsi parvenus à nos jours, nous pouvons distinguer les grandes familles de paradigmes suivantes :
- Les paradigmes déclaratifs : consistent à décrire ce que le programme doit accomplir, sans détailler explicitement comment l’exécuter.
- Les paradigmes impératifs : consiste à décrire comment le programme doit accomplir une tâche, en indiquant explicitement les instructions et les étapes à exécuter.
- Le multiparadigme : approche permettant de combiner plusieurs paradigmes dans un même langage ou programme.
Dans la famille des paradigmes déclaratifs nous avons les paradigmes :
- Fonctionnel : repose sur l’évaluation de fonctions mathématiques pures, évitant les états mutables et les effets de bord (exemples de langages de programmation axés sur ce type de paradigme : Haskell, OCaml).
- Logique : repose sur un ensemble de faits et de règles logiques ; le moteur déduit lui-même les réponses aux requêtes (exemple : Prolog).
- Déclaratif de requêtes / Domaine : expression directe du besoin (exemples : SQL pour les bases de données, HTML/CSS pour le rendu visuel).
Concernant la famille des paradigmes impératifs qui sautent généralement au premier coup d’œil nous pouvons citer les types suivants :
- Procédural : structuration du code en procédures et fonctions réutilisables (exemples : C, Bash).
- Orienté Objet (POO) : regroupement des données et des comportements au sein d’entités appelées objets, reposant sur des concepts comme l’encapsulation, l’héritage et le polymorphisme (exemples : Simula, Java, C++).
Concernant le multiparadigme, nous pouvons juste dire que la plupart des langages modernes de grand usage en font partie : Python, JavaScript, Rust, Go, C#, …
Vous l’auriez donc relevé, le scripting Bash relève de la grande famille des paradigmes impératifs et plus particulièrement du paradigme procédural, s’exécutant sous forme d’instructions séquentielles structurées par des boucles, des conditions et des fonctions.
Cependant, son caractère fusionnel type shell en font une spécialisation fondamentale en tant que langage d’orchestration ou « langage de colle » (glue language).
Conçu pour automatiser l’administration système et dialoguer avec le noyau Linux, Bash ne réalise pas les traitements lourds lui-même mais délègue le travail à des utilitaires spécialisés (grep, sed, awk, etc.) qu’il connecte entre eux grâce aux redirections et aux pipelines. C’est notamment en ce sens qu’interviennent les commandes Linux dont la bonne connaissance permettra de gagner davantage en puissance. D’ailleurs, ils vous sont présentés dans ce blog avec style : voir le billet « Aide-Mémoire Bash : Maîtriser les Commandes Linux par la Mnémonique Visuelle ».
3.2. Scripting bash et le typage
Disputé sur les plans esthétique et sécuritaire par différents bords, le typage fait référence à la façon dont on déclare et utilise des variables dans un langage de programmation. Pour le petit rappel, une variable est un espace mémoire que l’on réserve pour y stocker une valeur au cours de l’exécution d’un programme.
Pour simplifier, nous pouvons l’assimiler à une boîte dans notre garage ou magasin. Selon qu’on voudra y mettre tel ou tel contenu, nous pourrons réserver une boîte avec au besoin une étiquette spécifique. Pour certains, l’étiquette de type est collée directement sur la boîte (la variable) dès sa déclaration. La boîte sera dédiée à ne contenir qu’un seul type de contenu. Ce qui implique que le remplissage de ladite boîte se fait de façon contrôlée en fonction de l’adéquation étiquette-contenu, et cette vérification se fait avant même l’exécution (à la compilation). On parlera dans ce cas de typage statique.
Mais si le contenu de la boîte peut varier au fur et à mesure de son usage, l’étiquette n’est pas collée sur la boîte, mais directement sur la valeur (le contenu) qu’on y place ou déduite de visu. C’est à l’usage, au moment d’ouvrir la boîte au regard de ce qu’elle contient, qu’on pourra déterminer à quel type il appartient. En langage technique nous disons que le type est attaché à la valeur et vérifié à l’exécution (runtime), et dans ce cas, le langage de programmation fonctionnant de cette manière est dit à typage dynamique.
Cependant, savoir si le typage est statique ou dynamique ne suffit pas à définir pleinement le système de types d’un langage. Nous verrons ainsi apparaître les notions de typage fort et de typage faible.
Ici, le comportement ne s’évalue plus sur une variable isolée, mais lors des opérations entre plusieurs variables de types différents. Le langage exige-t-il des conversions explicites avant une opération, ou effectue-t-il lui-même des conversions automatiques (implicites) ?
Pour visualiser cela, prenons l’exemple d’une opération visant à faire l’addition entre du riz en vrac (évalué directement en kilos) et des sacs de riz fermés de 5 kg (évalués comme des unités/objets). Face à ce mélange, l’intention est ambiguë : faut-il compter le nombre total de kilos ou le nombre d’unités ?
- Dans un langage à typage faible, le système tente de résoudre l’ambiguïté lui-même. Il peut décider de convertir automatiquement les sacs en kilos pour réaliser l’addition. C’est la conversion implicite : le langage devine et adapte les types à la volée, au risque de commettre des erreurs d’interprétation si l’intention initiale était différente.
- À l’inverse, un langage à typage fort refusera de faire l’opération et lèvera immédiatement une erreur. Il exigera une conversion explicite préalable : le développeur doit indiquer clairement au programme s’il souhaite convertir le riz en vrac en « sacs », ou au contraire convertir les sacs en « kilos », afin de réaliser l’opération sur des types rigoureusement uniformes.
Dans le cas du scripting Bash, il se caractérise par un typage dynamique et faible, où les variables n’ont pas besoin d’être déclarées avec un type préalable et peuvent changer de valeur à l’exécution.
En réalité, Bash traite nativement toutes les variables comme des chaînes de caractères et effectue des conversions automatiques et implicites selon le contexte (par exemple lors de calculs arithmétiques), ce qui offre une grande souplesse d’écriture mais exige une vigilance constante pour éviter que des valeurs inattendues ou vides ne provoquent des erreurs silencieuses.
3.3. Scripting bash – la concurrence – le parallélisme et l’allocation dynamique de la mémoire
La concurrence et le parallélisme peuvent influer sur les performances d’un programme d’une part, et d’autre part, sur la sécurité des données ou de l’ensemble du système lorsque plusieurs ressources sont sollicitées en même temps, à l’instar de la mémoire qui pointe ici au premier rang.
A ce propos, Bash s’appuie directement sur les mécanismes du noyau plutôt que sur une gestion interne : il orchestre la concurrence via la création de processus système lancés en arrière-plan avec l’esperluette (&), synchronisés par la commande wait ou délégués à des outils externes comme xargs -P ou GNU parallel, sans recourir à des threads légers.
Sa gestion de la mémoire est quant à elle entièrement automatisée et abstraite (sans pointeurs comme en C++, ni allocation manuelle), ce qui est tout de même un bon point sur le plan de la productivité. Car si l’allocation manuelle offre un contrôle total sur les performances et l’empreinte mémoire (RAM), elle reporte toute la responsabilité de la gestion de la mémoire sur le développeur. Une seule erreur peut entraîner des problèmes majeurs dont le très célèbre dépassement de tampon.
Il est également à relever que les variables et tableaux s’ajustent dynamiquement sous forme de chaînes de caractères en RAM, ce qui offre une grande simplicité d’usage mais rend le langage inadapté au traitement lourd de données en mémoire sous peine de dégrader fortement les performances.
3.4. Scripting bash-points de vigilance, sécurité et robustesse du code
Le scripting Bash est un outil puissant mais délicat qui exige une rigueur particulière en matière de robustesse et de sécurité pour parer à son typage faible et aux inconvénients liés au laxisme qui pourraient en découler.
Pour se construire un cadre structurant fiable et sécurisé, la conception d’un script Bash nécessite d’activer d’emblée le mode strict ainsi qu’il suit : set -euo pipefail. A l’instar du shebang évoqué plus haut, il s’agit là d’un préalable ; une commande type à retenir qui aura pour principal avantage d’interrompre l’exécution à la moindre erreur ou variable indéfinie.
En outre, les autres points de vigilance devront se porter sur le fait :
- D’entourer systématiquement toutes les variables de guillemets pour parer aux problèmes liés aux espaces ;
- D’assainir rigoureusement les données d’entrée afin d’éviter toute injection de commandes ;
- De se protéger contre les destructions accidentelles en imposant de vérifier l’existence et la non-vacuité des variables avant de lancer des commandes critiques à l’instar de rm -rf qui sert à supprimer définitivement et sans confirmation un ou plusieurs fichiers et répertoires ;
- Veiller à restreindre les permissions des fichiers sensibles dès l’initialisation du script au moyen de umask 077. Cette commande configure les masques de permissions par défaut sous Linux et UNIX afin que tout nouveau fichier ou dossier ne soit accessible que par son propriétaire ou l’utilisateur qui l’a créé.
4. Intérêt en sécurité informatique et ouverture sur les projets d’apprentissage par problème
Le scripting Bash constitue un levier stratégique en sécurité informatique notamment en ce qui concerne les environnements Linux où il règne principalement en maître en backend et ronge parfois le terrain de prédilection au frontend face à Microsoft Windows.
Du haut de sa capacité à orchestrer directement les commandes système sans aucune dépendance externe, sa plus-value coule de source via sa vitesse d’exécution du pipelinage, permettant de chaîner instantanément des outils spécialisés tels que grep, awk, nmap ou autres, afin d’automatiser des tâches d’énumération en test d’intrusion (pentest), d’audit, ou de hardening. Ces trois étapes forment généralement un cycle logique et continu en sécurité informatique où :
- L’énumération constitue la phase d’exploration offensive permettant de cartographier la cible, d’identifier ses services actifs et d’en déceler les portes d’entrée exploitables. Nous pourrons noter à ce niveau son redoutable potentiel en matière de traitement de texte qui pourrait se révéler d’une efficacité hors norme quant au traitement approfondi et automatisé des rapports fournis par des outils de reconnaissance. Un aperçu du fonctionnement de theHarvester évoqué dans ce billet aura de quoi illustrer ce propos : « L’outil OSINT theHarvester : la puissance du renseignement au prix de l’intégration ».
- Les découvertes exploratoires ci-dessus peuvent directement alimenter l’audit de sécurité, qui adopte une posture d’analyse globale pour évaluer ces vulnérabilités et mesurer la conformité du système face aux exigences de sécurité.
- Enfin, les conclusions de cet état des lieux déclenchent naturellement le hardening (ou durcissement), la phase de réaction défensive qui permet d’appliquer les correctifs nécessaires. Et là encore, Bash a de quoi exceller tant qu’il s’agit d’agir en profondeur sur un système Linux ou mieux, sur plusieurs machines en même temps dans une dynamique de « pousser » des mises à jour se rapportant aux configurations, aux processus et procédures locales d’administration d’un parc informatique.
Par ailleurs, au sein d’un Security Operations Center (SOC), d’un Network Operations Center (NOC) ou au sein de toute autre unité organisationnelle assumant ce type d’opérations, la réponse à un incident peut se faire avec Bash qui s’impose dès lors comme un outil de premier secours indispensable pour mener un triage rapide, analyser massivement des logs d’accès et collecter des preuves volatiles (processus, connexions réseau) directement sur des systèmes compromis. Ce qui pourrait aussi être fait de façon proactive : préparer des scripts prêts à être exécutés en ce sens au cas où…
Les mini-projets qui suivront les uns après les autres auront, nous l’espérons, de quoi nourrir toute cette ingénierie. Happy scripting …
Références :
- https://aditya-sunjava.medium.com/a-developers-guide-to-the-unix-shell-choosing-between-bash-zsh-and-ksh-62ae3bb0a96b
- https://www.geeksforgeeks.org/linux-unix/different-shells-in-linux/
- Programming paradigms explained: a practical guide for developers — DevPebble
- Introduction of Programming Paradigms – GeeksforGeeks


